
В МФТИ разработали метод выявления ошибочных рассуждений искусственного интеллекта
В лаборатории фундаментальных исследований искусственного интеллекта МФТИ разработали метод, позволяющий выявлять некорректные рассуждения, которые генерируют большие языковые модели. Такая проверка особенно важна в медицине и других областях, где цена ошибки может быть очень высокой. Исследование опубликовано в журнале AI.
«Анализ дискурса не заменяет проверку фактов, но помогает выявлять структурно необоснованные цепочки рассуждений, даже если они изложены бегло и убедительно», — прокомментировал Борис Галицкий, ведущий научный сотрудник лаборатории фундаментальных исследований искусственного интеллекта Института искусственного интеллекта МФТИ.
Сегодня мы все чаще обращаемся к большим языковым моделям (LLM) как к своеобразным консультантам, которые помогают решать повседневные задачи и разбираться в сложных вопросах. При этом современные модели способны не только выдавать готовый ответ, но и демонстрировать последовательность шагов, которые к нему привели. Это позволяет оценивать ход рассуждений системы и в некоторых случаях повышать надежность ее выводов: пошаговое решение может помочь обнаружить ошибку, которая осталась бы незаметной в кратком ответе.
На ранних этапах развития таких технологий для этого использовали специальный прием промпт-инжиниринга — цепочку рассуждений (Chain-of-Thought, CoT). Пользователь формулировал запрос так, чтобы модель не ограничивалась итоговым ответом, а последовательно описывала промежуточные этапы решения. В современных больших языковых моделях способность генерировать подобные цепочки во многих случаях активируется автоматически.
Однако у LLM остается серьезная проблема — так называемые галлюцинации. Модели могут придумывать факты, ссылаться на несуществующие источники и даже создавать видимость последовательного рассуждения, которое на деле содержит логические ошибки. Как отмечает Борис Галицкий, «галлюцинации связаны не только с фактическим содержанием, но и с дискурсивной организацией рассуждений». Поэтому важно научиться систематически анализировать не только то, что сообщает языковая модель, но и то, как она выстраивает свои аргументы.
«Большинство существующих исследований галлюцинаций сосредоточено на фактических неточностях, вымышленных ссылках, неподтвержденных утверждениях или неправильных итоговых ответах. Между тем надежность диагностического или аналитического вывода зависит не только от достоверности отдельных фактов, но и от того, как в процессе рассуждения отбираются свидетельства, определяется их значимость, сопоставляются альтернативы и объединяются полученные данные», — говорит Борис Галицкий.
Предложенный исследователями метод основан на предположении, что сама структура рассуждения может служить индикатором галлюцинаций. Если проанализировать последовательность аргументов, их взаимосвязь и роль в формировании вывода, можно обнаружить признаки, отличающие обоснованное рассуждение от ошибочного. Таким образом, оценивать качество ответа можно не только по его содержанию, но и по тому, насколько логично модель использует доступную информацию.
Чтобы проверить эту идею, ученые подготовили выборку из 1000 сгенерированных жалоб пациентов на симптомы аутоиммунных и ревматологических заболеваний. В нее вошли случаи ревматоидного артрита, системной красной волчанки, анкилозирующего спондилита и других патологий. Жалобы намеренно формулировали неоднозначно: исследователи стремились исключить ситуации, в которых диагноз можно было бы определить по одному характерному слову или симптому.
Для каждой жалобы подготовили два варианта рассуждения, ведущего к диагнозу: обоснованный и галлюцинаторный. В первом случае модель опиралась на наиболее значимые симптомы, учитывала признаки, противоречащие первоначальной гипотезе, и сопоставляла несколько возможных диагнозов. Во втором варианте присутствовала одна из шести типичных ошибок (см. таблицу 1).
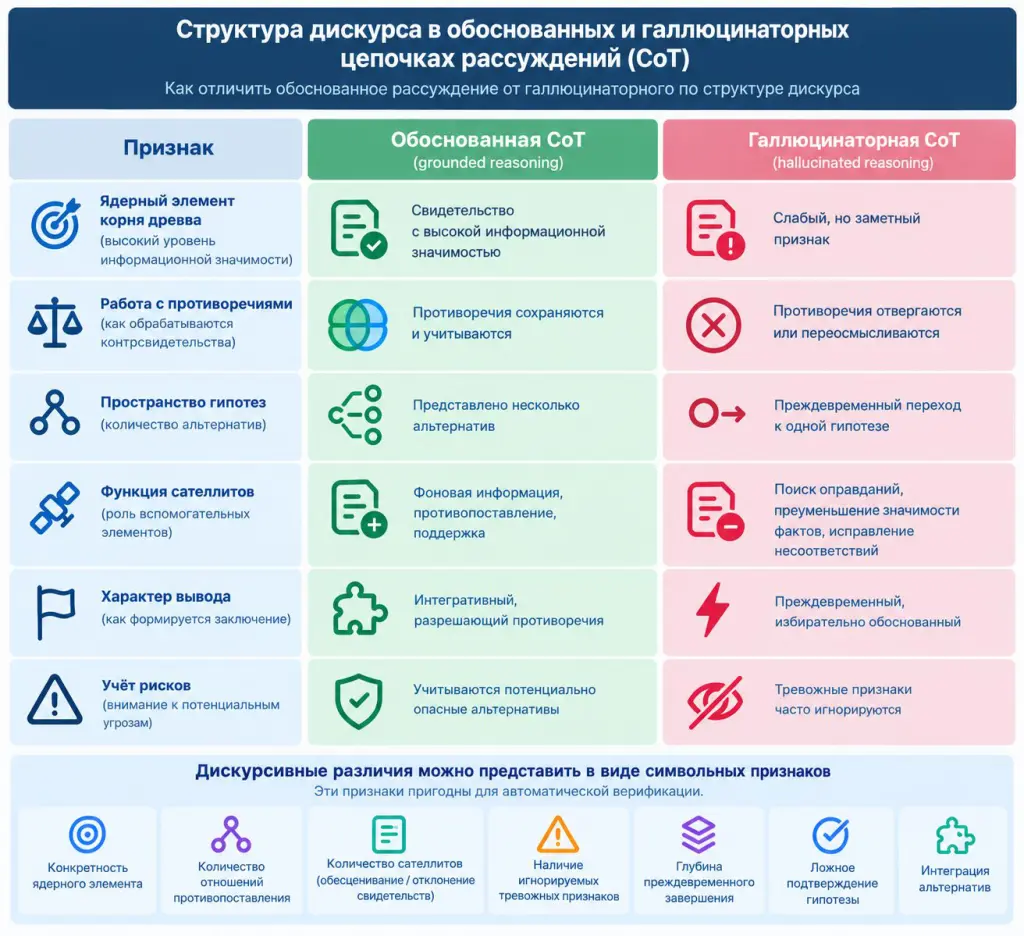
Затем исследователи представили каждое рассуждение в виде схемы. Для этого текст разделили на короткие смысловые фрагменты и присвоили каждому определенную роль: основное утверждение, подтверждающий аргумент, противоречащий довод, игнорирование неудобного факта или итоговый вывод. Получившаяся схема показывала внутреннюю организацию рассуждения: какие аргументы модель считает главными, какие использует в качестве дополнительных, учитывает ли противоречия и на каком этапе приходит к окончательному решению.
Сравнение схем обоснованных и галлюцинаторных рассуждений выявило заметные различия. В 79% обоснованных цепочек присутствовали свидетельства с высокой информативной значимостью, тогда как среди галлюцинаторных этот показатель составил всего 15%. Этап объединения различных фактов перед формулировкой вывода встречался в 79% обоснованных рассуждений и лишь в 16% галлюцинаторных. Кроме того, ошибочные цепочки в среднем оказывались короче и проще по структуре: модель быстрее переходила к заключению, пропуская этап сопоставления данных и альтернативных объяснений.
На следующем этапе исследователи обучили классификатор различать обоснованные и галлюцинаторные рассуждения, используя только информацию об их структуре. Иными словами, алгоритм не анализировал медицинское содержание текста и не проверял правильность диагноза, а ориентировался исключительно на схему аргументации. Даже в таком режиме классификатор правильно определял тип рассуждения примерно в 81% случаев.
Затем структурный признак объединили с двумя другими сигналами. Первый — геометрический — отражал, насколько сильно меняется рассуждение при повторной генерации ответа. Второй — абдуктивный — учитывал наличие более сильных диагностических гипотез, способных лучше объяснить имеющиеся данные. Совместное использование всех трех компонентов позволило классификатору правильно распознавать галлюцинаторные рассуждения в 84% случаев. Для сравнения: без структурного сигнала точность составляла только 72%. Дополнительные эксперименты показали, что ни один из трех признаков по отдельности не обеспечивает такого же результата. Они дополняют друг друга, позволяя надежнее выявлять ошибки.
Таким образом, структурный анализ может стать важным инструментом исследования галлюцинаций больших языковых моделей. Он позволяет обращать внимание на то, как система выстраивает аргументацию, какие свидетельства использует и не пропускает ли важные этапы рассуждения. Однако такой подход не заменяет проверку фактов: логически стройное объяснение само по себе еще не гарантирует достоверности содержащейся в нем информации.
«Нам удалось получить три важных результата. Во-первых, мы предлагаем набор данных для изучения характеристик галлюцинаторных диагностических рассуждений на уровне дискурса. Во-вторых, мы выявляем набор структурных дискурсивных признаков, позволяющих отличать обоснованные объяснения по цепочке мыслей от галлюцинаторных. В-третьих, мы демонстрируем, как эти признаки могут применяться для интерпретируемого обнаружения галлюцинаций и верификации рассуждений, способствуя разработке более надежных и объяснимых систем на основе больших языковых моделей», — подчеркнул Борис Галицкий.
Лаборатория фундаментальных исследований искусственного интеллекта — структурное подразделение Института искусственного интеллекта МФТИ. Основные направления ее работы включают разработку алгоритмов оптимизации в машинном обучении, развитие мультиагентных систем, генеративных моделей и больших языковых моделей, а также другие исследования в области искусственного интеллекта.
Источник: В МФТИ придумали, как поймать ИИ на лжи — За науку